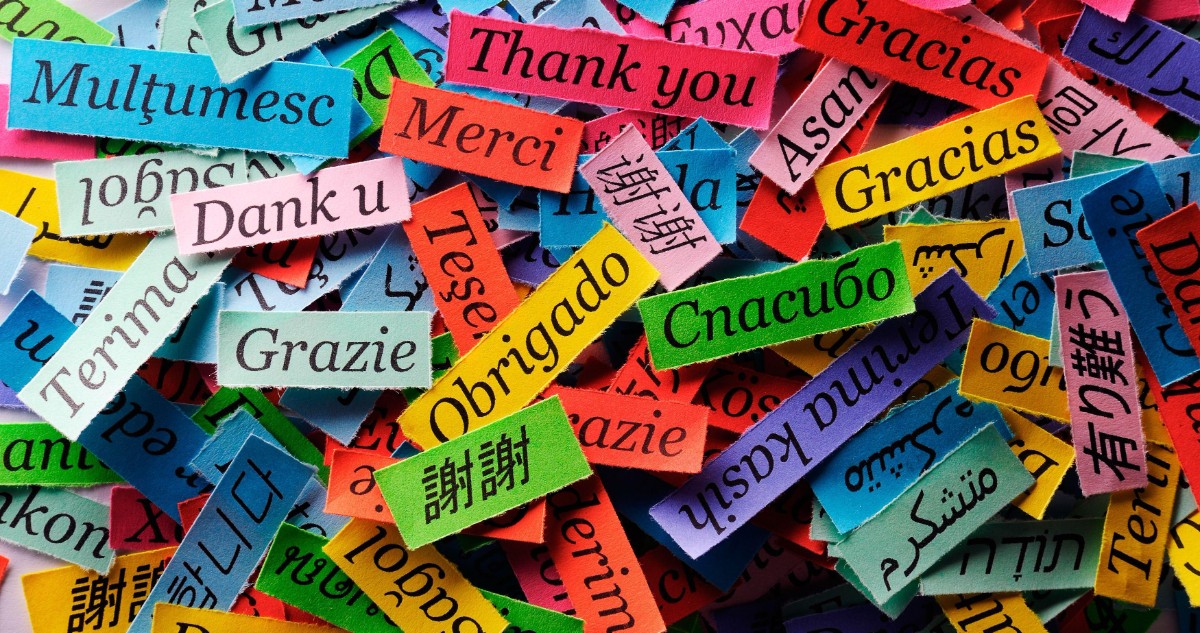
Dos personas hacen la misma pregunta a un asistente de inteligencia artificial. Una la escribe en inglés y la otra en un idioma con poca presencia en internet. El resultado es parecido, pero la segunda puede pagar bastante más por obtenerlo.
Esa es la conclusión de un estudio de la Coalición por la Equidad Lingüística en la Investigación de IA (Coalition for Language Equity in AI Research), publicado el mes pasado y recogido por el medio Rest of World, especializado en tecnología y su impacto fuera de Estados Unidos. Los investigadores lo bautizaron como un «impuesto del tokenizador» oculto, porque el recargo no aparece en ninguna factura como tal.
Qué es un token y por qué importa
Los modelos de inteligencia artificial no leen palabras como las entendemos. Primero un «tokenizador», una herramienta que corta texto, imágenes o audio en piezas pequeñas, convierte todo en «tokens», las unidades que el modelo procesa. Piensa en ellos como las fichas de un casino: cada consulta y cada respuesta consumen fichas, y por lo general se cobra según cuántas se usan.
El problema, según el estudio, es que no todos los idiomas necesitan la misma cantidad de fichas para decir lo mismo. Incluso entre los 20 idiomas más usados en internet hay diferencias. Los más caros emplearon entre 1,5 y 5 veces más tokens que los más baratos.
La brecha crece al ampliar el análisis a 200 idiomas. En uno de los modelos, la diferencia de costo llegó a multiplicarse por 17.
Más que una cuestión de precio
El documento advierte que una empresa emergente en Bengaluru (India) puede pagar un recargo en cada consulta y respuesta, mientras que su competidora en Austin (Estados Unidos) no. Además, más tokens significan más demora y menos espacio para trabajar. Estas penalizaciones, dice el estudio, golpean más donde la capacidad de cómputo y la conectividad ya son limitadas, y la inequidad del tokenizador es una restricción sobre quién puede participar de la economía de la IA.
Pratyush Choudhury, cofundador de Activate AI, el primer fondo de capital de riesgo de India dedicado solo a la inteligencia artificial, explicó que los idiomas distintos del inglés dejan menos espacio para documentos o historial de conversación. También exigen más trabajo para generar la respuesta.
Ese espacio se llama «ventana de contexto», es decir, la cantidad de texto que el modelo puede tener presente a la vez. Choudhury lo ejemplificó con un tutor: recordar los errores y explicaciones previas de un estudiante es parte de una buena clase. Si ese historial llena la ventana mucho más rápido en un idioma, la desventaja llega hasta la calidad del servicio.
Dicho de otro modo, la diferencia no se limita a pagar más por lo mismo. También puede significar una herramienta que olvida antes, responde más lento y rinde menos para quien no usa un idioma dominante.
El alfabeto pesa tanto como la rareza
Ser un idioma poco hablado no lo explica todo. El estudio halló que la escritura tiene un rol grande. El asturiano, con relativamente pocos hablantes y sin datos en Common Crawl (un enorme archivo público de páginas web que se usa para entrenar modelos), se beneficia de usar alfabeto latino y de su parentesco con lenguas como el italiano.
En el otro extremo, los idiomas escritos en alfabetos que el tokenizador vio poco, como birmano, tibetano, tifinagh, jemer, lao y ol chiki, quedaron en mayor desventaja de forma sistemática en casi todos los modelos analizados.
Dheemanth Reddy, director ejecutivo de Maya Research, firma que desarrolla IA conversacional pensada para hablar y responder como un hablante nativo, señaló que muchos tokenizadores siguen optimizados para el inglés y otros idiomas con abundantes datos. La raíz, dijo, es la falta de datos digitales de calidad.
Qué se propone para corregirlo
Una vía es mejorar los datos de base. Raoul Nanavati, cofundador y director ejecutivo de la startup india Navana.ai, citó la iniciativa abierta RESPIN, hecha con el Instituto Indio de Ciencias y financiada por la Fundación Gates, que reunió texto de hablantes nativos de 38 dialectos junto con voz leída.
Pero Reddy advirtió que mejores datos no bastan. Los precios de los tokens bajan rápido, de modo que el impacto directo en el bolsillo debería atenuarse con el tiempo. Sin embargo, cerrar la brecha exigirá que los laboratorios diseñen a propósito tokenizadores que manejen mejor esos idiomas y escrituras.
Choudhury pidió tratar la eficiencia lingüística como un requisito de producto, junto con la precisión, la velocidad y la fiabilidad. Reconoció que la igualdad perfecta quizá sea irreal, pero sostuvo que las diferencias grandes y persistentes deberían tener una explicación y un plan de mejora.
Su propuesta concreta es que cada gran laboratorio publique una tabla por idioma con lo que cuesta completar tareas comparables con éxito, y que se comprometa a mejorar en los idiomas peor atendidos.
¿Cómo hicimos esta nota?
Esta nota fue redactada con la inteligencia artificial de Claude (Anthropic). El periodista investigó preliminarmente, seleccionó las fuentes y las entregó a Claude para su redacción usando como referencia el estilo de escritura del autor. Luego el periodista revisó la nota, realizó ediciones y verificó sus fuentes.
 Enviando corrección, espere un momento...